BTC
Bitcoin
6 365 362 ₽
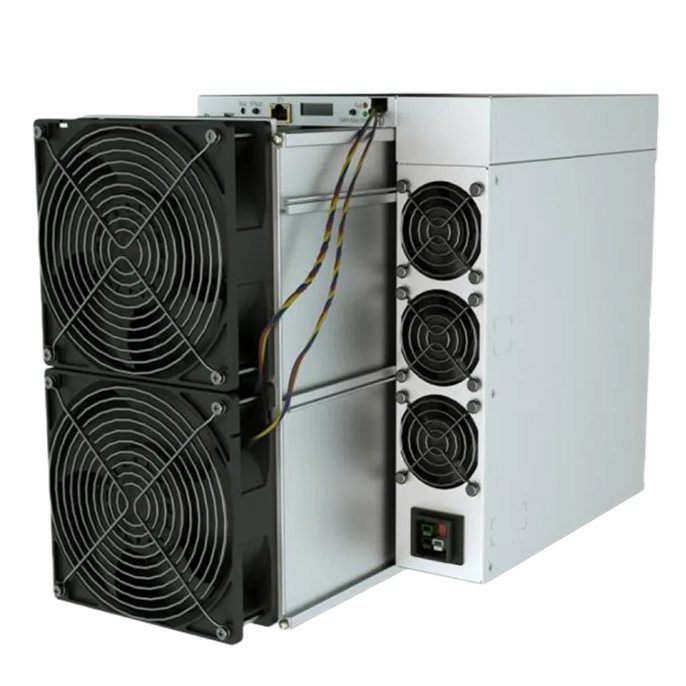
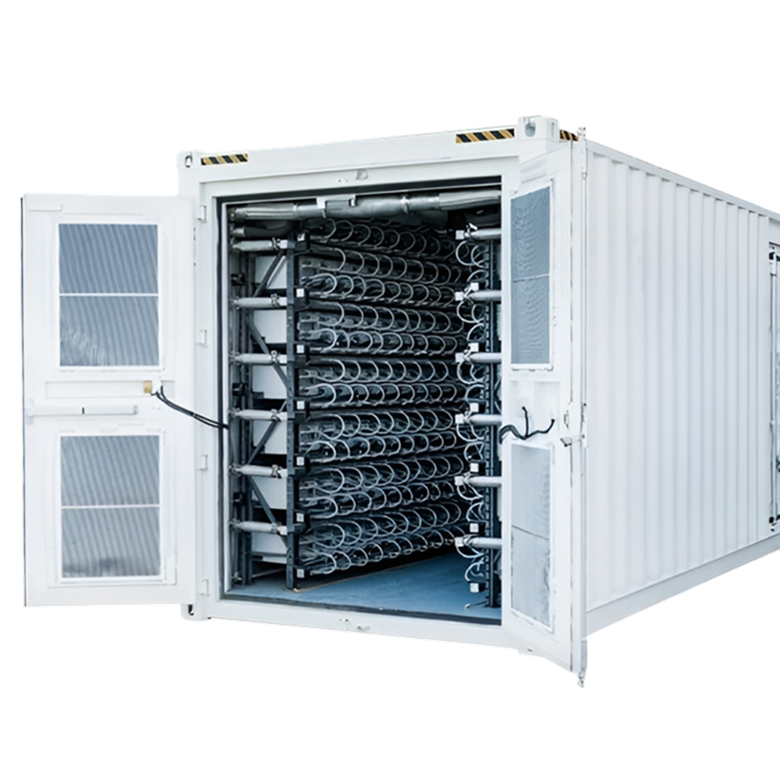
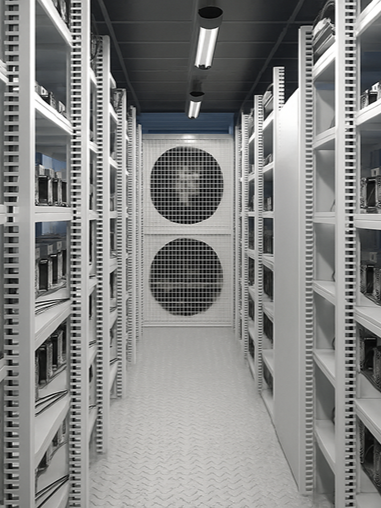


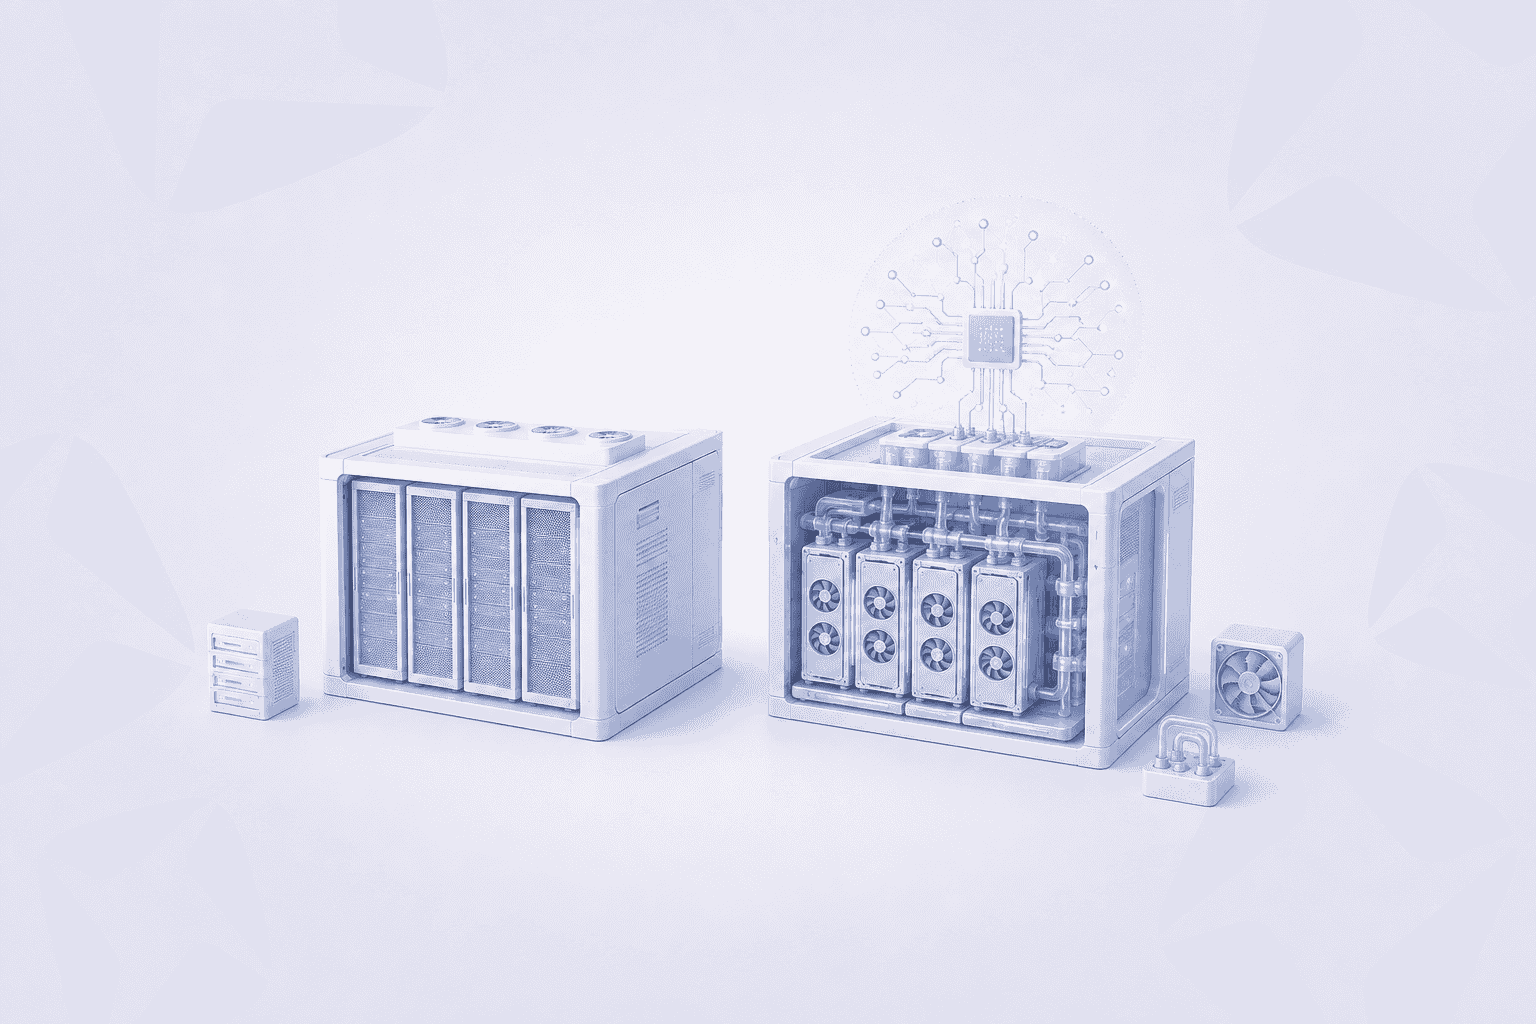
AI-дата-центр — это центр обработки данных, спроектированный для высокоплотных вычислительных кластеров на GPU и других ускорителях, которые используются для обучения и работы моделей искусственного интеллекта. От обычного ЦОД он отличается прежде всего четырьмя вещами: значительно большей вычислительной плотностью, повышенной мощностью на стойку, более требовательным охлаждением и высокоскоростной сетью между вычислительными узлами.
Обычный ЦОД рассчитан на широкий набор задач: виртуальные машины, корпоративные приложения, базы данных, веб-сервисы, хранение данных. Большая часть такой нагрузки может выполняться на CPU-серверах, причем каждый сервер относительно независим от соседних.
В AI-дата-центре ситуация другая. При обучении крупных моделей одна вычислительная задача распределяется между множеством GPU, которые постоянно обмениваются данными. Поэтому производительность AI-кластера зависит не только от самих ускорителей. Если не хватает пропускной способности сети, мощности электроснабжения или охлаждения, дорогостоящее вычислительное оборудование не сможет работать с полной эффективностью.
При этом не любой проект с искусственным интеллектом требует отдельного AI-дата-центра. Несколько GPU-серверов можно разместить в обычном ЦОД, если его инженерная инфраструктура справляется с нагрузкой. Специализированный AI-дата-центр нужен прежде всего там, где речь идет о крупных и высокоплотных вычислительных кластерах.
Строительство дата-центров Promminer — проектирование и строительство промышленных дата-центров под ключ с расчетом энергоснабжения, инженерной инфраструктурой, монтажом оборудования и вводом объекта в эксплуатацию.
AI-дата-центр отличается не тем, что в нем просто установлены GPU. Главное различие — в архитектуре всей площадки вокруг параллельных вычислений.
| Критерий | Обычный ЦОД | AI-дата-центр |
|---|---|---|
| Основная нагрузка | Веб-сервисы, базы данных, виртуальные машины, корпоративные системы | Обучение моделей, инференс, генеративный ИИ, HPC |
| Вычислительная инфраструктура | Преимущественно CPU | Большое количество GPU и других ускорителей |
| Плотность энергопотребления | Обычно умеренная | Значительно выше в вычислительных кластерах |
| Охлаждение | В основном воздушное | Воздушное, гибридное или жидкостное |
| Сеть между серверами | Для многих задач достаточно стандартного Ethernet | Требуется высокая пропускная способность и низкая задержка |
| Масштабирование | Серверы часто можно добавлять относительно независимо | Вместе с GPU приходится масштабировать сеть, питание и охлаждение |
На практике это означает, что обычный ЦОД оптимизирован для размещения большого количества разных IT-систем, а AI-дата-центр — для максимальной эффективности вычислительного кластера.
Именно поэтому два дата-центра одинаковой площади могут сильно различаться по требованиям к электрической мощности, охлаждению и сетевой инфраструктуре.
GPU-серверы создают гораздо более концентрированную нагрузку на инженерную инфраструктуру, чем большинство традиционных серверных систем. В одной стойке может находиться несколько мощных вычислительных узлов с большим количеством ускорителей.
Рост потребляемой мощности одновременно означает рост количества тепла, которое необходимо отвести. Поэтому ограничением становится не только общая доступная мощность дата-центра, но и возможность подать необходимую мощность к конкретной стойке и удалить выделяемое ею тепло.
Для менее плотных AI-систем может быть достаточно воздушного охлаждения. По мере увеличения мощности оборудования воздух становится менее эффективным способом переноса тепла, поэтому в высокоплотных конфигурациях применяется жидкостное охлаждение, в том числе direct-to-chip. В такой системе тепло от наиболее нагруженных компонентов передается жидкому теплоносителю через холодные пластины.
При этом жидкостное охлаждение не обязательно полностью заменяет воздушное. В одном сервере или зале часть тепла может отводиться жидкостью, а остальные компоненты продолжат охлаждаться воздухом.
Для обычного ЦОД подобная инфраструктура может оказаться избыточной. Для крупного AI-кластера она становится одним из условий нормальной работы оборудования.
Поэтому при попытке разместить AI-нагрузку в существующем ЦОД важно смотреть не только на свободное место. Наличие пустой стойки еще не означает, что площадка способна обеспечить ее необходимой электрической мощностью и охлаждением.
В традиционном ЦОД многие серверы выполняют свои задачи относительно независимо. Веб-сервер, база данных или виртуальная машина используют сеть, но их вычислительная производительность не всегда напрямую определяется скоростью обмена данными с десятками или сотнями соседних серверов.
В крупном AI-кластере одна задача может одновременно выполняться большим количеством GPU. Во время обучения модели ускорители регулярно передают друг другу данные и синхронизируют результаты вычислений.
Из-за этого медленная или перегруженная сеть способна стать таким же ограничением, как недостаточно производительный GPU. Ускоритель может завершить свою часть вычислений и затем простаивать, ожидая данные от других узлов.
Поэтому для AI-инфраструктуры особенно важны:
высокая пропускная способность между вычислительными серверами;
низкая задержка передачи данных;
предсказуемая работа сети под большой одновременной нагрузкой;
быстрый доступ вычислительных узлов к системам хранения данных.
В результате AI-кластер проектируется как единая вычислительная система. Производительность определяется сочетанием GPU, сети, хранения, питания и охлаждения, а не характеристиками одного сервера.
Это одно из наиболее существенных отличий AI-дата-центра от традиционного ЦОД: в AI-инфраструктуре недостаточно просто увеличить количество серверов — все основные инженерные и вычислительные подсистемы должны масштабироваться вместе.
Можно, если масштаб проекта соответствует возможностям площадки.
Для нескольких серверов, используемых для инференса, корпоративных AI-приложений или относительно небольших вычислительных задач, существующий ЦОД часто подходит без радикальной перестройки инфраструктуры.
Ситуация меняется по мере роста кластера. Чем больше ускорителей устанавливается, тем сильнее становятся взаимосвязаны четыре ограничения:
Электропитание. Нужно обеспечить достаточную мощность не только всему объекту, но и конкретным стойкам.
Охлаждение. Система должна отводить тепло при длительной работе оборудования под высокой нагрузкой.
Сеть. Пропускная способность между вычислительными узлами должна расти вместе с размером кластера.
Масштабирование. Площадка должна иметь резерв для установки следующей партии оборудования без полной переделки инженерных систем.
Поэтому граница между обычным и специализированным AI-дата-центром определяется не количеством GPU как таковым. Важнее то, насколько инфраструктура площадки рассчитана на высокоплотные параллельные вычисления.
Несколько GPU-серверов не превращают обычный ЦОД в AI-дата-центр. Специализированная AI-инфраструктура появляется тогда, когда питание, охлаждение, сеть и системы хранения проектируются с учетом требований крупных вычислительных кластеров.
Для большинства компаний, которым требуется несколько AI-серверов, строить специализированный дата-центр не имеет смысла. Рациональнее использовать существующую площадку или готовые мощности провайдера, если они соответствуют требованиям оборудования.
AI-дата-центр становится оправданным прежде всего в трех сценариях:
планируется крупный GPU-кластер для обучения моделей;
требуется высокая плотность вычислительного оборудования в ограниченной площади;
кластер будет регулярно расширяться, поэтому инфраструктуру необходимо заранее проектировать с запасом по питанию, охлаждению и сети.
Обратная ситуация тоже возможна. ЦОД может называться AI-площадкой, но если в нем просто размещено несколько GPU-серверов среди традиционного оборудования, технически его инфраструктура может почти не отличаться от обычного дата-центра.
Поэтому при сравнении площадок лучше ориентироваться не на термин AI data center в описании, а на конкретные возможности: допустимую мощность на стойку, систему охлаждения, сетевую архитектуру и условия масштабирования вычислительного кластера.
AI-дата-центр — это ЦОД, инфраструктура которого специально рассчитана на высокоплотные параллельные вычисления на GPU и других ускорителях. Обычный дата-центр предназначен прежде всего для широкого набора традиционных IT-нагрузок и обычно не требует такой концентрации мощности, охлаждения и сетевой пропускной способности.
Ключевые различия сводятся к четырем параметрам: вычислительной архитектуре, мощности на стойку, охлаждению и сети между серверами.
Небольшое количество AI-серверов можно разместить в обычном ЦОД. Но для крупного GPU-кластера недостаточно просто установить ускорители: питание, охлаждение, сеть и системы хранения должны быть спроектированы как части единой вычислительной инфраструктуры. Именно это и превращает площадку из обычного ЦОД в специализированный AI-дата-центр.
Материал носит исключительно информационный характер и не является индивидуальной инвестиционной рекомендацией. Информация в материале не учитывает индивидуальные финансовые цели, инвестиционный профиль и допустимый уровень риска конкретного лица.