BTC
Bitcoin
6 365 362 ₽
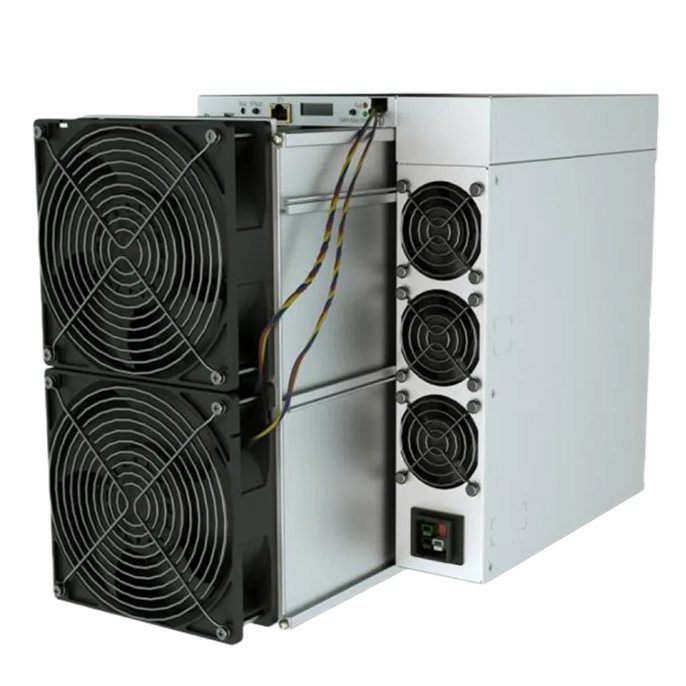
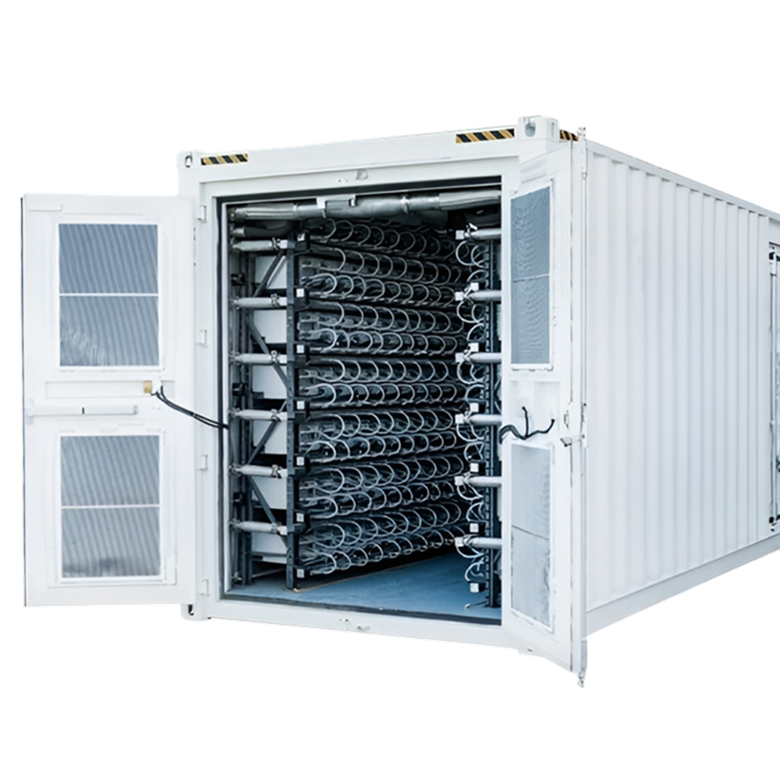
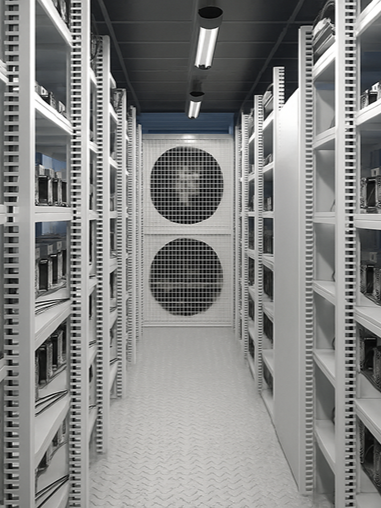


После ввода майнингового дата-центра в работу нужно организовать не просто обслуживание оборудования, а полноценную систему эксплуатации. Для большинства площадок она должна включать круглосуточный мониторинг ASIC и инженерной инфраструктуры, дежурную смену с понятными зонами ответственности, регламент действий при авариях, плановое техническое обслуживание, ремонтный процесс, запас ЗИП и учет причин простоев.
К началу штатной эксплуатации должно быть понятно, кто отвечает за ASIC, электроснабжение, охлаждение, сеть и ремонт, какие события требуют немедленной реакции и кто принимает решение при массовом отказе оборудования. Если эти функции распределены заранее, дата-центр меньше зависит от конкретных сотрудников и быстрее восстанавливается после сбоев.
Небольшая площадка может работать с компактной сменой и значительной долей удаленного мониторинга. На крупном объекте лучше разделять ответственность между специалистами по майнинговому оборудованию и инженерной инфраструктуре. Для Hydro-дата-центров дополнительно требуется персонал, который умеет обслуживать жидкостный контур: применять к такой площадке регламент воздушного охлаждения нельзя.
Строительство дата-центров Promminer — проектирование и строительство промышленных дата-центров под ключ с расчетом энергоснабжения, инженерной инфраструктурой, монтажом оборудования и вводом объекта в эксплуатацию.
Переход от запуска дата-центра к постоянной работе начинается с передачи объекта эксплуатационной команде. На этом этапе важно не ограничиваться фактом, что ASIC включены и выдают хешрейт. Персоналу нужны актуальный перечень оборудования, схема ответственности, доступ к мониторингу, эксплуатационные регламенты и понятный порядок действий при отклонениях.
Минимальная эксплуатационная система включает следующие элементы:
| Функция | Что нужно организовать | Кто отвечает |
|---|---|---|
| Мониторинг | Контроль ASIC, электроснабжения, сети и охлаждения | Дежурная смена |
| Реакция на аварии | Уровни критичности и порядок эскалации | Старший смены или ответственный инженер |
| ASIC | Диагностика, вывод из работы, передача в ремонт | Техперсонал по майнинговому оборудованию |
| Инженерные системы | Контроль питания и охлаждения | Инженерная служба |
| Ремонт | Учет неисправностей и восстановленных устройств | Ремонтная группа или сервис |
| ЗИП | Запас типовых деталей и расходных материалов | Ответственный за склад |
| Аналитика | Учет простоев, аварий и фактического хешрейта | Руководитель эксплуатации |
На небольших объектах один сотрудник может совмещать несколько функций. На крупных дата-центрах такое совмещение создает риск: при аварии один специалист одновременно пытается диагностировать ASIC, проверять питание и связываться с руководителем. Поэтому чем больше площадка, тем важнее формально разделять роли.
Практический ориентир простой: до начала штатной работы должно быть понятно, кто обнаруживает проблему, кто ее локализует, кто принимает решение и кто отвечает за восстановление оборудования.
Эксплуатация майнингового дата-центра должна строиться на постоянном мониторинге, а не на ручных обходах. Для каждого ASIC желательно контролировать доступность, фактический хешрейт, температуру, ошибки компонентов, состояние вентиляторов для воздушных моделей и связь с пулом. Одновременно система должна отслеживать инженерную инфраструктуру, потому что массовые отказы майнеров часто связаны не с самими ASIC, а с электроснабжением, сетью или охлаждением.
Пороговые значения нельзя назначать одинаковыми для всего парка. Нормальные температуры, потребление и другие параметры зависят от модели ASIC, режима работы и типа охлаждения. Для каждой группы оборудования лучше зафиксировать штатные диапазоны и формировать предупреждение при отклонении от них.
Особенно важно отслеживать не только состояние «работает — не работает», но и постепенное ухудшение параметров. ASIC может оставаться доступным в сети, но выдавать сниженный хешрейт. Если система видит только факт подключения устройства, такой простой мощности может оставаться незамеченным.
Уведомления лучше разделить минимум на три уровня:
информационные события, которые не требуют немедленного вмешательства;
неисправности отдельных ASIC или локальных компонентов;
критические события, затрагивающие группу оборудования или инженерную систему.
При аварии сотрудники сначала должны определить масштаб события. Если вышел из работы один ASIC, проверяют само устройство, питание и сетевое подключение на его участке. Если одновременно отключились десятки майнеров, первым шагом должна быть проверка общей инфраструктуры.
Рабочий алгоритм выглядит так:
Определить, сколько оборудования затронуто.
Проверить питание, сеть и охлаждение общего участка.
Локализовать источник отказа.
Отдельный неисправный ASIC вывести из работы и передать в диагностику.
После восстановления проверить возвращение оборудования к штатным параметрам.
Зафиксировать причину и длительность простоя.
При массовом сбое не стоит начинать с последовательной перезагрузки каждого ASIC. Если причина находится на уровне линии питания, сетевого узла или системы охлаждения, такие действия только увеличат время восстановления.
Техническое обслуживание дата-центра лучше строить по двум принципам: регулярные профилактические работы и обслуживание по фактическому состоянию оборудования. Жесткий календарь сам по себе недостаточен, потому что скорость загрязнения, нагрузка на охлаждение и характер неисправностей отличаются у разных площадок.
Для ASIC с воздушным охлаждением эксплуатационная команда должна контролировать загрязнение оборудования, состояние вентиляторов и свободный проход воздуха. Периодичность очистки определяется условиями на конкретном объекте, а не универсальным сроком.
Для Hydro-площадок эксплуатационная модель меняется. При использовании Bitmain Antminer S21+ Hydro, Bitmain Antminer S21e Hydro или других Hydro-ASIC нужно отдельно контролировать состояние жидкостного контура, насосного оборудования и теплообмена. Такие площадки требуют отдельного регламента и подготовленного персонала.
Работы удобно делить на три категории:
ежесменные — просмотр аварий, отклонений хешрейта, температуры и состояния инженерных систем;
плановые — очистка, осмотр соединений, обслуживание систем охлаждения, проверка резервных элементов;
по состоянию — замена вентиляторов, блоков питания, сетевых компонентов и других узлов после появления признаков неисправности.
После каждого ремонта нужно сохранять историю устройства: причина неисправности, выполненные работы, замененные компоненты и дата возврата в работу. Без этого повторяющиеся дефекты невозможно нормально анализировать.
Отдельно организуется склад ЗИП. Держать запас «на всякий случай» неэффективно: его состав должен соответствовать установленному парку и статистике отказов. В первую очередь нужны компоненты, которые чаще всего выводят ASIC из работы и могут быть быстро заменены на площадке.
Чем более унифицирован парк, тем проще эксплуатация. Например, если основную часть оборудования составляют Bitmain Antminer S21 PRO, S21 XP или S21+, проще стандартизировать диагностику и склад, чем поддерживать большое количество небольших групп разных платформ. Аналогичная логика работает для парка Whatsminer M60, M60S или M61.
Унификация не означает обязательный переход на одну модель. Ее задача — уменьшить количество разных комплектующих, процедур и сценариев ремонта.
Работа дата-центра не должна оцениваться только по количеству включенных ASIC. Главный показатель — насколько стабильно площадка поддерживает ожидаемый хешрейт и как быстро восстанавливается после отказов.
Для регулярного контроля достаточно нескольких показателей:
доля работающих ASIC от общего парка;
фактический хешрейт относительно ожидаемого;
количество оборудования в ремонте;
суммарная продолжительность простоев;
основные причины остановок;
количество повторных неисправностей;
среднее время восстановления после аварии;
аварии инженерной инфраструктуры.
Важно анализировать именно причины потерь. Один и тот же итоговый простой может возникать из-за совершенно разных проблем. Массовые остановки по питанию требуют работы с электрической инфраструктурой, регулярный перегрев — с охлаждением, а длительное ожидание ремонта ASIC — с запасом деталей и организацией сервиса.
Поэтому эксплуатационный отчет должен отвечать не только на вопрос «сколько оборудования работает сейчас», но и на вопрос почему оборудование простаивало и что нужно изменить, чтобы такой простой не повторился.
После завершения пусконаладки нельзя продолжать управлять объектом как временным проектом. Во время запуска допустимы ручные проверки и оперативное устранение отдельных замечаний. При постоянной эксплуатации такой подход быстро перестает работать.
Критичны пять ошибок:
Отсутствие единой системы мониторинга. Сотрудники замечают проблему позже, чем она возникает.
Неопределенная ответственность. При аварии несколько человек проверяют одно и то же или, наоборот, никто не принимает решение.
Ремонт без истории оборудования. Повторяющиеся неисправности не выявляются.
Недостаточный ЗИП. Простой увеличивается из-за ожидания типовой детали.
Одинаковый подход к единичным и массовым отказам. Персонал начинает проверять отдельные ASIC вместо поиска общей причины.
Для Hydro-площадок отдельной ошибкой будет использование регламентов, разработанных для воздушного охлаждения. Различаются не только способы отвода тепла, но и набор систем, которые персонал обязан контролировать.
Перед окончательным переводом дата-центра из режима запуска в штатную работу стоит проверить шесть пунктов:
Все ASIC и основные инженерные системы подключены к централизованному мониторингу.
Для каждой смены назначен ответственный и определены зоны ответственности.
Есть регламент аварий, уровни критичности и порядок эскалации.
Организованы техническое обслуживание и история ремонтов оборудования.
Сформирован ЗИП под установленный парк ASIC и реальные сроки поставки деталей.
Руководитель получает данные о хешрейте, простоях, ремонтах и причинах отказов.
Если хотя бы один из этих элементов отсутствует, дата-центр может технически работать, но его эксплуатация остается зависимой от ручного контроля и конкретных сотрудников.
Для большинства майнинговых дата-центров оптимальна централизованная модель: круглосуточный мониторинг, дежурная смена с понятной ответственностью, отдельный регламент аварий, плановое обслуживание, учет ремонта, склад ЗИП и регулярный анализ причин простоев.
Небольшая площадка может значительную часть контроля выполнять удаленно и привлекать внешних специалистов для ремонта. На крупном объекте разумнее разделять функции между специалистами по ASIC и инженерной инфраструктуре. Hydro-дата-центр дополнительно требует отдельной компетенции по эксплуатации жидкостного охлаждения.
Хорошо организованная эксплуатация — это система, в которой проблема автоматически обнаруживается, быстро классифицируется, передается ответственному сотруднику, устраняется по регламенту и затем учитывается в статистике. Именно такой подход позволяет поддерживать стабильный хешрейт и сокращать потери от простоев.
Материал носит исключительно информационный характер и не является индивидуальной инвестиционной рекомендацией. Информация в материале не учитывает индивидуальные финансовые цели, инвестиционный профиль и допустимый уровень риска конкретного лица.